一个 100G 的 txt 文件,按指定行内容分割为若干个文件,如何处理?
例如:这个文件有几亿行,其中会有大概 20 行的内容是”my content\t“
想以这个内容将文件分割开,如何在内存 16GB 的电脑上实现呢?
• 请不要在回答技术问题时复制粘贴 AI 生成的内容

请教高效分割 txt 大文件(100GB)方案( Python , Java , shell)
Nick2VIPUser · nickliqian · Apr 9, 2020 · 8361 viewsThis topic created in 2398 days ago, the information mentioned may be changed or developed.
 |
1
边读边写,线性时间,内存占用超低。
|
 2
 |
2
歪楼,为啥会有这样的文件啊,可怕
|
 |
3
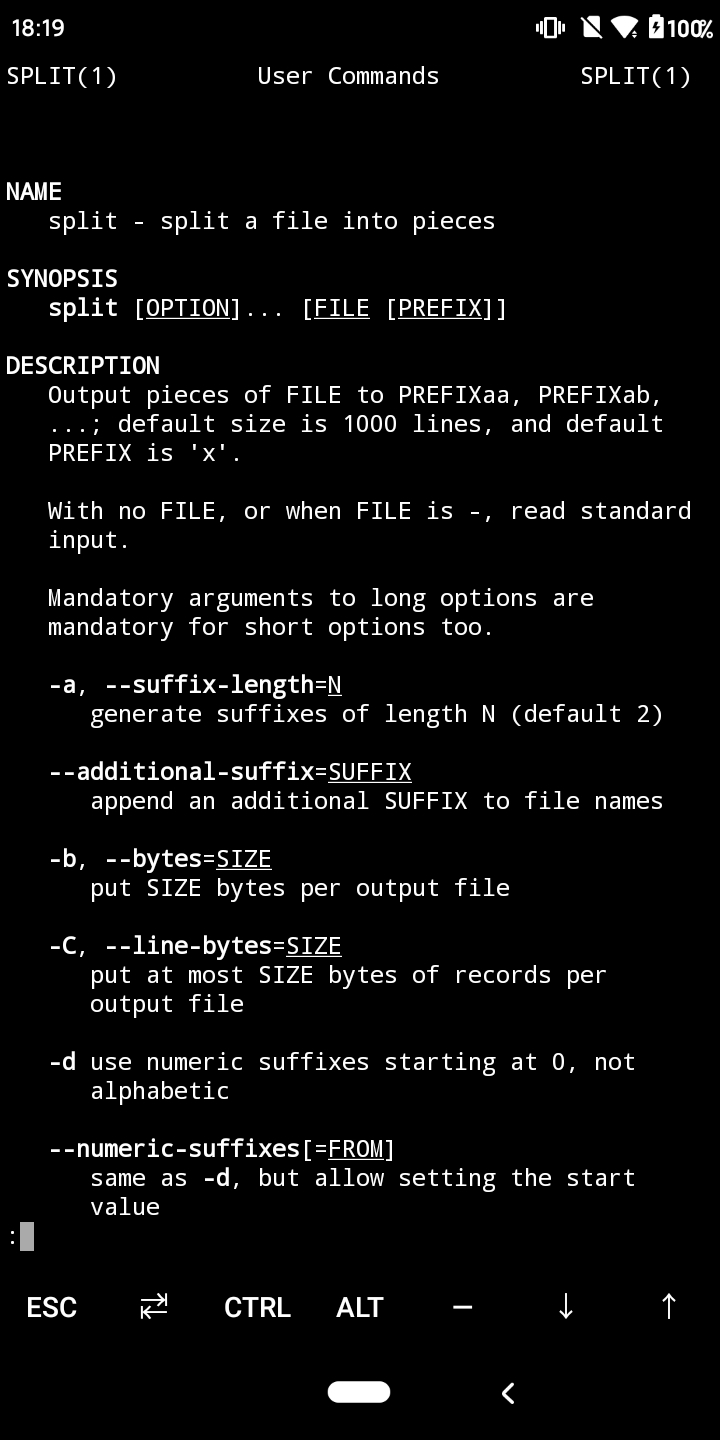
用 split ?
 |
|
xupefeiApr 9, 2020 via iPhone
4
如果是 ssd 的话,可以把文件分块后多线程扫描来拿到分隔符位置。对于每个位置,起一个线程从那个位置开始边读边写,直到遇到下一个分隔符。
|
 |
5
根据内容分割需要用 csplit 。
|
|
alan0liangApr 9, 2020 via Android
6
哦看错了 一楼流处理正解
|
 |
luckyrayyyApr 9, 2020
7
你的难点在哪?如果说只是不能一次性读到内存,那就一边读一边处理呗。是否还有其他困难?
|
|
vuuvApr 9, 2020 via Android
8
毕竟只会生成 20 多个文件,都是顺序大块读写。
如果可能,写的目的地不要放在同一块磁盘上。 复制到 SSD 后能加快处理时的读取速度。但是你复制也要时间。自行决策吧。 提前创建个小文件测试下命令行参数效果。 |
 |
9
@xupefei 是的~我的想法是读 2GB,然后逐行写入,依次循环。我打算先计算预计需要的时间...如果是读一行写一行,算了一下时间不能承受。
|
|
10
@littleylv 因为自己的某些 zhizhang 操作...哭了
|
|
11
@vuuv 我回去试试
|
 |
yxtApr 9, 2020 via Android
12
emeditor?
|
|
13
@luckyrayyy 目前准备是按 2GB 分批读,然后逐行判断和写入,目前还在找 python 相关的 api 进行实现
|
|
14
@vuuv 是了~我打算放在 ssd 上跑一下
|
 |
pcblApr 9, 2020 via Android
15
反正才 100g 如果只是一次性处理的话,一行一行的读取都行,然后预估下内存最大可以放多少行在超出之前写入到文件
|
|
yxtApr 9, 2020 via Android
16
emeditor 最大支持大概 250g 先搜索,bookmark all,然后 split done
|
 |
aptupdateApr 9, 2020 via iPhone
17
在 SSD 里面把线程拉满然后边读边写,你是想分割成 20 个文件吗?感觉分割完 20 个 5GB 大小的文件后续处理也够呛。好奇 100GB 的 txt 文件是什么东西……
|
 |
also24Apr 9, 2020
18
提醒下,边读边写方案,如果你是 HDD,最好分开在两个硬盘进行,或者读取一长段数据( x GB )后再一次性写入,避免大量的随机读写降低 IO 性能。
如果是 SSD 的话可以不用管这个。 |
 |
caolaApr 9, 2020
19
逐行读,判后再写入新文件……
|
 |
lineApr 9, 2020
20
cat | awk
|
 |
rayray314Apr 9, 2020 via Android
21
emeditor
|
 |
cheng6563Apr 9, 2020
22
就算是 HDD 同盘复制缓冲区给个 50M 就行了,没必要上 GB
|
 |
lululauApr 9, 2020
23
zsh:
offsets=($(echo 1; grep -b 'my content' big.log | cut -d: -f1; stat -c%s big.log)) for ((i=1; i < $#offsets; i++)) { echo dd if=big.log of=small.$i.log bs=1 count=$[$offsets[i+1]-$offsets[i]] skip=$[$offsets[i]-1] } |
|
24
zsh:
offsets=($(echo 1; grep -b 'my content' big.log | cut -d: -f1; stat -c%s big.log)) for ((i=1; i < $#offsets; i++)) { dd if=big.log of=small.$i.log bs=1 count=$[$offsets[i+1]-$offsets[i]] skip=$[$offsets[i]-1] } |
 |
25
mmap 内存映射,一个映射读的文件,一个映射写的文件,64mb 一个块,一个块 commit 一次,hdd 没有任何压力。
|
 |
qinruiApr 9, 2020 via iPhone
26
awk 一行一行的读
|
 |
scriptB0yApr 9, 2020
27
|
 |
rrfengApr 10, 2020 via Android
28
sed
awk 都能轻易完成… |
 |
popbonesApr 10, 2020
29
|
 |
msg7086Apr 10, 2020
30
读进 buffer 然后扫描分割就行了吧。
一次读比如说 128M,扫描完,再读下一块,如果能多线程跑更好,IO 扔给子线程。 |
 |
marcomarcoApr 10, 2020 via iPhone
31
txtkiller 了解一下
|
 |
sxfscoolApr 10, 2020
32
bufio
|
 |
danteggApr 10, 2020
33
sed +1
|
 |
BlackBerry999Apr 10, 2020
34
按行读,边读边写。
|
 |
matepiApr 10, 2020
35
边读边写不就完了么
真正难的是让你快速定位到随机第 n 行的内容 |
 |
zz554952942Apr 10, 2020
36
go
开一个生产者协程 负责读取文本 读到换行符则塞到通道上 然后开一定量的消费者协程负责取然后写入 |
 |
llussyApr 10, 2020
37
split -b 10G log.txt newfile
|
 |
feelingluckyApr 10, 2020
38
@littleylv 以前很多日志都还存文件系统的时候,一天就要好几百 G 了…🤣
|
 |
augustheartApr 10, 2020
39
逐字节线性读入就行。你只需要长度为“my content\t”的缓存就行
|
 |
JimiJimiApr 23, 2020
40
流处理,一行一行读
|
 Select Language